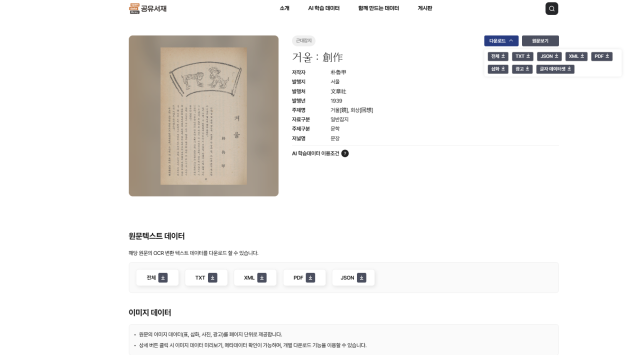
書籍、表、挿絵、広告、写真など、合計3800万件以上のデータが全国民に公開される。
国立中央図書館は、国家文献から構築した人工知能(AI)学習データを初めて一般に公開すると17日に発表した。
公開対象は、テキストデータ(Hidden Text PDF、XML、TXT、JSON)3974冊、表・挿絵・広告・写真などの画像データ2万1485件、メタデータ、文字単位の文字データセット3830万件など、合計3833万件に達する。
今回のデータ開放に伴い、既存のプロジェクトプラットフォームである「共有書庫」をAI学習データ活用に最適化されたプラットフォームに改装した。この改編は、AI学習、学術研究、サービス・アプリ開発、コンテンツ制作など多様な目的で誰でも簡単に利用できるように利便性を強化することに焦点を当てている。
開放データは、国立中央図書館が所蔵するデジタル化された原文の中で著作権が解決された1930~40年代の近代雑誌、1940~60年代の政府刊行物及び教科書、国立中央図書館発行資料とAI学習利用許可を受けたオープンアクセス(Open Access、OA)学術論文などである。誰でも「共有書庫」で自由に閲覧し、ダウンロードして活用できる。
テキストデータは、人工知能(AI)が認識しやすいように精製された高品質な形で提供され、研究やサービス開発に即座に活用できる。文字データセットは、さまざまな形態の文字データをAI学習に直接活用できるため、大規模データの確保に苦しむ中小・ベンチャー企業もAI基盤の文字認識(OCR)・自然言語処理など関連技術開発に幅広く利用できることが期待されている。
新しくなった「共有書庫」は、人工知能(AI)とデジタル人文学研究支援、公共データ活用の拡張のための機能も強化された。デジタルで蓄積された膨大な知識資料を人工知能(AI)が学習できる形に整理・加工することで、従来は困難だった大規模データに基づく人文学研究も可能になる。研究者は文献・記録・画像などさまざまな資料を人工知能(AI)で分析し、新たな意味を導き出すデジタル人文学研究をより容易に行えることが期待されている。
また、著作権問題が解決された国家文献をAI学習に直接活用できる形で大規模に開放するという点でも意義がある。これまで学習データの確保にコストと著作権の負担を抱えていた研究者や中小・ベンチャー企業の負担が若干軽減されることが期待される。
プラットフォームのユーザー環境も利用者に優しく改善された。直感的な画面構成と資料タイプ及び画像タイプ別の探索構造が適用され、別途の登録手続きなしに誰でも簡単にデータにアクセスできるため、専門研究者だけでなく一般利用者も容易に資料を検索し活用できる。
国立中央図書館は、今年年末にハングルのタッキ本小説300冊のテキストデータを追加開放するなど、今後もデータ構築と開放を持続的に拡大し、人工知能(AI)活用サービスを高度化して、「共有書庫」を持続的に成長できるデータプラットフォームに発展させていく計画である。
イ・ヒョンジュ国立中央図書館デジタル情報企画課課長は「今後データ開放の範囲を着実に広げ、国民誰もが公共知識資源の恩恵を享受できる人工知能(AI)時代の図書館を作っていく」と述べた。
* この記事はAIによって翻訳されました。
亜洲日報の記事等を無断で複製、公衆送信 、翻案、配布することは禁じられています。
