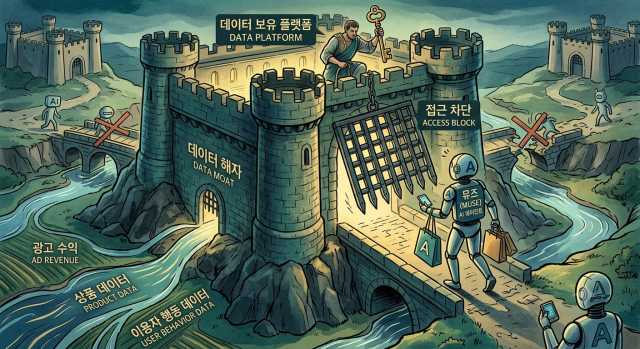
アマゾンはメタの個人AIエージェント『ミューズ(Muse)』の自社ショッピングサイトへのアクセスを突然遮断した。パープレキシティ、オープンAI、グーグルに続いてメタも遮断され、データを握るプラットフォームが自社の『データモート』を守るためにAIエージェントへの無料アクセスを許可しない方針が固まっている。
26日、IT業界によると、アマゾンは現地時間20日夜からミューズのアマゾン.comへのアクセスを遮断した。アマゾンはメタにミューズの削除を求めたが、メタがこれを拒否したため、遮断に踏み切った。現在、ミューズを使ってアマゾンでショッピングしようとするユーザーには利用規約違反というポップアップが表示され続けている。
ミューズはメタが今月8日に初めて発表した消費者向けAIエージェントで、旅行予約やメール・スケジュール管理、決済まで代行する。アプリとウェブ、WhatsAppで利用でき、無料プランと月20ドル・100ドルの有料プランに分かれている。発売直後にアプリストアで1位に輝き、話題を呼んだが、2週間でアメリカ最大のオンラインショッピングサイトで足止めされた。
アマゾンが掲げた理由はセキュリティである。メタが事前に通知せず、エージェントが自らをボットだと明かさずに接続し、顧客のログイン情報を収集・保存しているように見えるというものである。メタは反論した。メタのスーパーインテリジェンスラボの副社長タレク・シェアシャは、ログイン情報がセキュリティストレージに直接入るため、メインエージェントには見えないと説明した。
今回の遮断は単発ではない。アマゾンは過去1年間、コメットブラウザを巡ってパープレキシティを提訴し、グーグルとオープンAIのショッピングエージェントも遮断した。グーグルの場合、クローラーアクセス規則を含むrobots.txtファイルを修正して遮断し、その結果、一部のAI検索結果からアマゾンの商品ページが消えた。遮断対象はすべて自社のコマース基盤がないか弱い企業である。他社のショッピングサイトのデータを借りてサービスを作る構造が崩れたことになる。
その背景には広告収益がある。アマゾンは昨年、広告だけで680億ドル以上を稼ぎ、この事業はユーザーがページを巡回し、スポンサー商品を見ることに依存している。今年第2四半期の広告収益は198億1000万ドルで、前年同期比26%増加した。エージェントが商品を選び、決済まで完了すると、検索窓、比較画面、決済フローなどアマゾンが収益を上げる接点がすべて消えてしまう。
メタも同様の論理を用いたことがある。メタは昨年10月にWhatsAppビジネスの利用規約を変更し、ChatGPTやパープレキシティなどの汎用AIチャットボットのアクセスを遮断し、この規定は1月15日から施行された。アマゾンも二重基準の論争から逃れられない。アマゾンの『バイフォーミー(Buy for Me)』は、アマゾンにない商品を見つけると外部ショッピングサイトに接続し、名前・住所・決済情報を代わりに入力する。自社のエージェントは他社のデータを使用し、他社のエージェントは遮断する構造である。結局、原則の問題ではなくデータ所有権の問題である。
法的手段も弱まっている。米第9連邦控訴裁判所は8月にアマゾンのコンピュータ詐欺防止法(CFAA)訴訟戦略を弱める判断を下し、残された手段は利用規約の執行程度である。訴訟よりも技術的遮断と交渉が主な戦線となる構造である。
業界は最終的にデータアクセスが有料化される方向に収束すると見ている。ビッグテック間で『データ紳士協定』を結ぶか、エージェント開発会社がデータ保持者に手数料を支払う形である。グーグルがレディットと年間6000万ドル規模のデータライセンス契約を結んだように、コンテンツ領域ではすでに前例が積み重なっている。エージェント競争の軸がモデル性能から小売・予約・コンテンツデータの確保へと移行する流れである。
ただし、データを持つ企業がすべて『上』になるわけではない。交渉力は交換可能なデータから生まれるが、これを持つ企業は少数である。データを保有していてもその価値を理解していないか、AIがすぐに利用できる『AIレディデータ』に精製できていない企業がほとんどである。企業のAI転換(AX)の出発点がモデル導入ではなくデータ整備であるべきだという指摘が出ている理由である。
国内も同様の構図に入っている。ネイバーは検索・ショッピング・ブログ、クーパンは商品・価格・配送、カカオはダイアリーのポータルコンテンツというデータ資産を持っている。グローバルエージェントの国内進出が本格化すれば、これらプラットフォームのアクセス政策が交渉の基準線となる。
* この記事はAIによって翻訳されました。
亜洲日報の記事等を無断で複製、公衆送信 、翻案、配布することは禁じられています。
