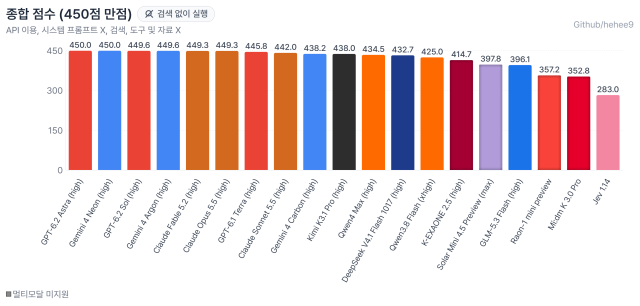
2027年度大学入試センター試験が終了した中、アメリカ、中国、韓国などの主要な人工知能(AI)モデルが大学入試問題を解いた結果、オープンAIとグーグルのモデルが並んで450点満点を記録した。
科学技術情報通信部が推進する独自AIファウンデーションモデル(独パモ)プロジェクトに参加するLG AI研究所とアップステージのモデルは相対的に低い点数を受けた。特に画像が含まれる問題で正答率が大きく低下し、グローバル最上位モデルよりもマルチモーダル性能が劣ることが明らかになった。
20日、順天郷大学コンピュータソフトウェア工学科の具ユギョム氏は『2027年度大学入試センター試験巨大言語モデル(LLM)解答ダッシュボード』を公開した。
このダッシュボードによると、2027年度大学入試センター試験で満点を記録したモデルはオープンAIの『GPT-6.2アストラ(Astra)』とグーグルの『ジェミナイ4ネオン(Neon)』であった。
アンソロピックモデルも高い成績を示した。『クロード・フェイブル5.2』と『クロード・オペラス5.5』もそれぞれ449.3点と集計された。オープンAIの『GPT 6.1テラ』も445.8点を記録した。
中国モデルも高い点数を記録した。中国AI企業『キミ』の『K3.1プロ』は438点であった。キミは国語、英語、韓国史の領域で満点を獲得したが、数学と探求領域でそれぞれ96点と92点を受けた。
中国アリババグループのモデル『キューウェン4マックス』も国語、英語、韓国史の領域で100点を獲得した。一方、数学と探求領域でそれぞれ96点と88.5点を記録した。
対照的に国内AIモデルはグローバル最上位モデルとの点数差を示した。LG AI研究所の『K-エクサワン2.5』は総414.7点で、オープンAIアストラより35.3点低かった。数学と韓国史の領域で満点を記録したが、国語98点、英語96点、探求領域では70.7点にとどまった。
アップステージの『ソーラミニ4.5プレビュー』は397.8点を記録し、満点モデルとの点差は52.2点であった。韓国史の領域でのみ満点を獲得し、国語91点、数学95.7点、英語96点、探求領域65.2点と集計された。
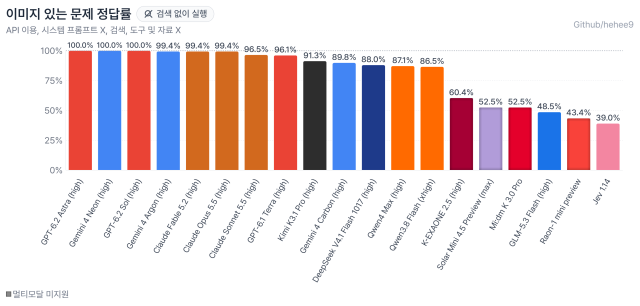
特に国内モデルは画像が含まれる問題で低い正答率を示した。画像がある問題の正答率はGPT-6.2アストラとジェミナイ4ネオン、GPT-6.2ソルがすべて100%を記録した。クロード・フェイブル5.2とクロード・オペラス5.5もそれぞれ99.4%に達した。
これに対し、K-エクサワン2.5の画像を含む問題の正答率は60.4%にとどまった。ソーラミニ4.5プレビューは52.5%と集計された。アストラと比較するとそれぞれ39.6ポイント(p)、47.5p低い水準である。
専門家はこのようなモデル性能の差が学習データ、モデル規模、推論能力などの複合的要因から生じていると分析した。最病虎考慮大学人工知能研究所の研究教授は「グローバルビッグテックと国内企業モデルのパラメータ規模と推論段階で利用できるコンピューティングインフラのレベルに大きな差がある」とし、「画像を含む問題は光学文字認識(OCR)技術で情報を正確に抽出した後、推論する過程が必要であり、ビッグテックの場合、推論モデル性能を大きく向上させたため、結果に差が出ざるを得ない」と指摘した。
続けて「学習データの差も重要な要因」とし、「グローバルビッグテックは大学入試センター試験の過去問題や問題集などを事前に学習した可能性があるが、国内企業は関連データを十分に確保できていない可能性がある」と付け加えた。
* この記事はAIによって翻訳されました。
亜洲日報の記事等を無断で複製、公衆送信 、翻案、配布することは禁じられています。
