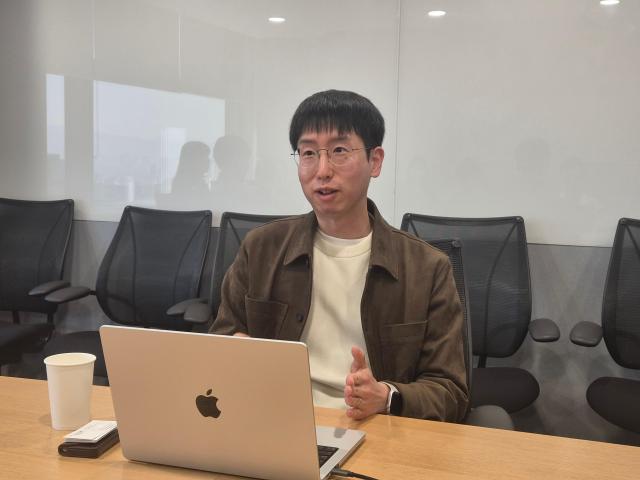
エヌビディアは韓国語を世界の人工知能(AI)学習技術開発の出発点とした。韓国語データを生成し学習する技術を確保した後、これを他国や他の言語に拡張する計画である。世界的な技術競争力を持つ韓国を基盤に、グローバルAIエコシステムでの影響力を広げようとする動きと解釈される。しかし、韓国語研究を通じてエヌビディアが得る具体的な事業的利益については、オープンなAIエコシステムの形成という原則的な説明を行った。
キム・ヒョヌエヌビディアリサーチマネージャー兼エヌビディア・KAIST共同AI研究所長は、10日ソウル江南区のエヌビディアコリアオフィスで行われた記者会見で「KAISTが世界で非常に注目される学校になったため」と述べ、韓国に共同研究所を設立した背景を説明した。
キム所長は「KAISTの優れた研究成果と我が国語が中間資源言語という独特の位置にあることが相まって、韓国人の高いAIへの関心も加わり、黄金の機会が生まれた」と評価した。
エヌビディアが注目した韓国語の価値は、世界AI市場に拡張できる研究基盤であるという点である。韓国語は英語や中国語のように学習資源が豊富ではないが、少数言語よりはデータが多い「中間資源言語」に該当する。新しいデータ学習技術を開発し検証するのに有利な条件であると説明されている。
キム所長は「我が国語から始めて他の言語にも適用できるデータ学習方法を公開することが目標である」と述べ、「良い木一本を作るのではなく、森を作る方法を研究し、世界に分かち合いたい」と語った。
韓国語研究がエヌビディアの事業にどのような利益をもたらすのかという質問には、具体的な収益モデルを示さなかった。彼は「会社としてはオープンなAIエコシステムを夢見ている」とし、「我が国語を始めとして、世界が使える方法論を研究し、各国が自国の言語のAIを作ることを目指している」と答えた。
エヌビディアとKAISTが昨年7月に設立を発表した共同研究所は、エヌビディアがアジアで大学と設立する初の共同AI研究所である。両者は今後5年間で総額3億ドル(約4000億ウォン)規模の協力を推進する。これらのうち2億5000万ドルはコンピューティング資源として支援し、残りの資金の具体的な運用方法は議論中である。
キム所長は「世界的なAIビッグテックが我が国に研究所を設立し、研究者を採用し始めたという点で意義がある」とし、「韓国の研究者の優れた能力を示し、より多くのグローバル企業が国内に研究所を設立するようにしたい」と述べた。
他の大学との協力が拡大する可能性も示唆した。彼は「私たちがうまくやって、他の企業も韓国の能力を見て入ってくることが目標である」と語った。
ソウル大学との協力とは性格が異なると説明した。エヌビディアがソウル大学と推進中のAI技術センター(NVAITC)は共同研究と教育中心である。一方、KAIST共同研究所にはエヌビディアの正規職研究員を直接採用し、コンピューティング資源を支援する。
研究所の運営はまだ初期段階である。キム所長は「研究者の採用を始めており、年内に数名を採用する計画である」と述べた。国内のエヌビディアクラウドパートナーとGPU資源の確保を協議中であり、具体的な機材の数量は確定していない。
最近、エヌビディアのリーダーシップ問題に関連して最高経営者(CEO)が交代しても研究所の運営が継続できるかという質問もあった。キム所長は「その部分についてお話しできる適任者ではないと思うが、研究所長として与えられた任務を滞りなく遂行することが目標である」と答えた。
共同研究所の核心課題は韓国語学習データの不足を解決することである。発表資料によると、多言語学習データセットであるmC4において、韓国語文書は約2400万件で、英語39億3000万件の163分の1の水準である。
キム所長は「質の高い我が国語の公開データセットを見つけるのは本当に難しい」と述べ、「特定の分野だけでなく、全分野にわたって不足している」と指摘した。続けて「人が生成するデータだけではギャップを縮めることは難しい」とし、合成データ生成と既存データを効率的に学習する技術を研究する考えを示した。
成果も現れている。キム所長が先に公開した韓国語合成データセット『ネモトロンペルソナコリア』は、ハギングフェイスで10日間、世界の人気データセット1位を記録した。ダウンロード数も約14万回に達した。
国内企業の活用事例も出てきた。キム所長は「LG AI研究所が前日に公開した『K-エクサワン2.5』にこのデータセットが活用された」と述べ、「互いの成果を活用してより良いモデルを作るエコシステムの好循環事例である」と評価した。
合成データ活用に伴う著作権問題も研究課題として挙げられる。キム所長は既存のAIモデルがどのように原本データを確保したのかは分からないと説明した。研究所はすでに学習済みモデルの知識を活用して新しいデータを生成する方法に集中する計画である。
研究成果物は特定の企業が独占しないように公開する方向を推進する。キム所長は「ネモトロンペルソナデータセットも商業利用できるように公開した」と述べ、他の企業も活用できるデータと学習方法を開発する考えを示した。
初の研究成果公開時期は来年下半期を予想している。キム所長は「面白いプロジェクトが準備されているので、来年下半期頃に公開される可能性がある」と述べ、「我が国で始まった研究が世界AIエコシステムに貢献するようにしたい」と語った。
* この記事はAIによって翻訳されました。
亜洲日報の記事等を無断で複製、公衆送信 、翻案、配布することは禁じられています。
