巨大言語モデル(LLM)を活用した人工知能(AI)推薦システムが、自らの推薦結果を再学習することで特定の項目に対する偏りや誤った推薦が繰り返される可能性があるとの研究結果が発表された。
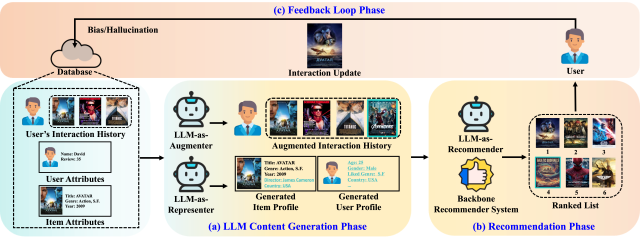
8日、ウルサン科学技術院(UNIST)によると、李延昌教授率いるAI大学院チームは、LLMに基づく推薦システムにおける偏りや誤りの発生と蓄積の過程を追跡する診断ツール『エコトレース(EchoTrace)』を開発した。研究チームはこれを用いて、LLMが推薦リストを直接作成する場合やユーザープロフィール、学習データを生成する三つの方法を分析した。
LLMが推薦リストを直接作成した場合、推薦対象にない項目を提示した割合は、映画が4.07%、書籍が7.4%、店舗が13.14%であった。映画の利用記録を基に推定したユーザーの職業は、93.16%が実際の記録と異なっていた。学習用に生成したデータも特定のジャンルや業種に偏っていた。最終的な推薦では、実際の利用記録に比べて人気項目がより頻繁に登場した。
推薦結果を再学習する過程を五回繰り返しても、初期の偏りや誤りは消えなかった。一部のシステムでは人気項目への偏りがさらに大きくなった。特にLLMが映画を直接推薦するモデルでは、ユーザー100人中86〜92人が次の映画を選ぶ際に、自らが先に推薦した作品を最も重要な参考としていた。AIが提示した推薦がユーザーの選択記録として学習され、次の推薦に反映される『フィードバックループ』が初期の偏りや誤りを持続させたのである。
李教授は「今回の研究は、LLMに基づく推薦システムの偏りと幻覚が、繰り返しの推薦過程でどのように蓄積され、増幅されるかをLLMの役割に応じて体系的に診断するための基盤を提供した」と述べた。
* この記事はAIによって翻訳されました。
亜洲日報の記事等を無断で複製、公衆送信 、翻案、配布することは禁じられています。
