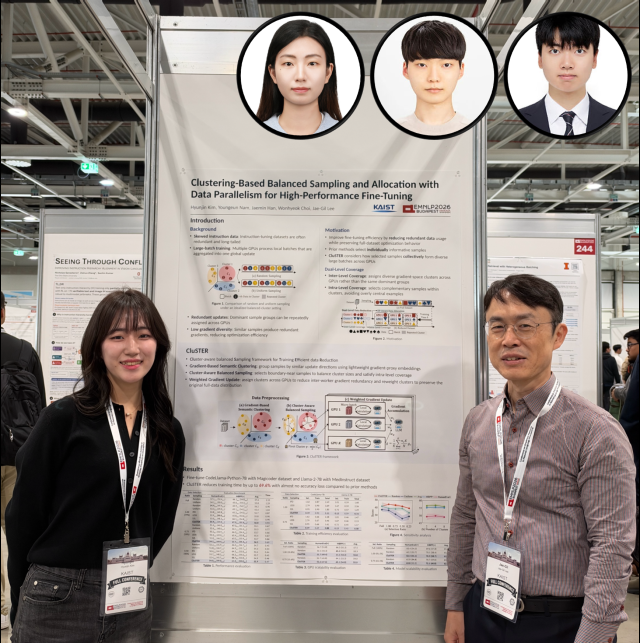
KAISTの研究チームは、AIに医療やコーディングなど特定の分野を教える追加学習時間を最大69.6%短縮する技術を開発した。学習効果が類似するデータを削減し、異なるデータを複数のGPUに均等に分配することで、10時間かかっていた学習を約3時間で完了できるレベルに達した。
KAISTは、計算機科学科の李在吉教授の研究チームが、学習に類似した影響を与えるデータを選別し、複数のGPUに均等に配分する大規模言語モデルの微調整技術『クラスター(CluSTER)』を開発したと2日に発表した。
微調整は、幅広い知識を持つAIにコーディング問題や医療分野の質問と回答を追加で学習させ、特定の分野に特化させるプロセスである。このプロセスには計算量が多く、複数のGPUが学習データを分担して処理する。GPUはAI学習に必要な計算を迅速に行う半導体である。データを無作為に分割すると、学習効果が類似するデータが複数のGPUで繰り返し処理されることになる。既に解決した問題と類似の問題ばかりを解くことになり、計算量に対して得られる学習効果が小さくなる。
クラスターは、まず各データがAI学習に与える影響を分析し、類似するデータをまとめる。テーマが同じであったり、似た単語を使用しているかどうかを基準にするのではない。外見上異なる問題でも、AIに似た解法能力を教える場合は同じグループに分類される。学生に加算を教える際に『リンゴ2個と3個を足す問題』と『鉛筆2本と3本を足す問題』は、話の内容は異なっても学ぶ計算方法は同じであるという原理である。
その後、各グループからデータを選別し、複数のGPUが多様な学習情報を均等に処理できるように配分する。問題集で類似の問題を減らしつつ、必ず習得すべきさまざまなタイプの問題は漏れなく残して分けて解く方式である。データ量を減らすだけでなく、選択したデータを複数のGPUが効率的に活用できるようにしたことが特徴である。
研究チームは、コーディングおよび医療分野の学習データ3種類を用いて、約70億個および130億個のパラメータを持つ大規模言語モデルを微調整し、合計8つの性能評価試験で効果を確認した。パラメータはAIが学習しながら調整する内部数値で、学習した知識を回答に反映するために使用される。全データの約31%のみを選んで学習したにもかかわらず、モデルの性能はほぼ維持され、学習時間は最大69.6%短縮された。実験はGPU4台の環境を中心に行われ、GPU8台の環境でも従来の方法より優れた性能を示した。
GPUを追加投入せずに、学習資料を適切に選別し配分するだけでAI学習の効率を高められることを示した結果である。企業や研究機関が顧客相談、コーディング支援、医療の質問応答など特定目的のAIを開発する際、追加学習にかかる時間とGPU使用コストを削減できるというのが研究チームの説明である。
李在吉教授は「AI学習の効率を高めるためには、GPUを多く使用するだけでなく、どのデータを学習するかを賢く選ぶことも重要である」と述べ、「今回の研究は、既存のGPU資源をより効率的に活用し、大規模AIモデルの学習負担を軽減できる点で意義がある」と語った。
* この記事はAIによって翻訳されました。
亜洲日報の記事等を無断で複製、公衆送信 、翻案、配布することは禁じられています。
